Najlepšie malé AI modely pre váš notebook: zostava na lokálne spustenie
Model qwen3.5:4b-q4_K_M napíše text, vysvetlí vec a odpovie na bežné otázky úplne bez internetu aj na bežnom notebooku so 16 GB pamäte. Poznáte ho z druhej časti série: ako univerzálny asistent sa osvedčí. Na hľadanie vo vlastných súboroch ani na programátorské úlohy však nie je tou správnou voľbou. Ak od jediného stiahnutého modelu čakáte, že zvládne všetko, zostane vám jeden preťažený model namiesto troch malých, z ktorých má každý svoju úlohu.
Ak chcete mať lokálnu AI pod kontrolou, musíte si vedome vybrať model, softvér na jeho spustenie a licenciu aj rozhodnúť, kde zostanú vaše dáta. Ak ste si ešte neoverili RAM alebo VRAM svojho notebooku, začnite článkom koľko RAM potrebuje notebook na lokálnu AI. Ak ešte nemáte nainštalovanú Ollamu, postup nájdete v návode ako nastaviť prvého lokálneho poskytovateľa AI. Tu už predpokladáme, že máte oboje za sebou. Teraz prichádza otázka, ktoré modely si vybrať a ako zistiť, či za niečo stoja.
Najlepšie malé AI modely podľa úlohy
Na tri rôzne úlohy sa hodia tri samostatné modely, nie jeden, od ktorého čakáte všetko.
Univerzálny asistent na bežné rozhovory, návrhy textov a rýchle otázky: qwen3.5:4b-q4_K_M. Súbor na stiahnutie má 3,4 GB; ide o rovnaký tag ako v druhej časti.
Menší špecialista na užšie vymedzenú úlohu, napríklad štruktúrovaný výstup alebo uvažovanie podľa zadaných pravidiel: granite4.2:3b. Súbor na stiahnutie má 2,2 GB, model vyšiel v auguste 2026 a má licenciu Apache 2.0. V časti 6 nájdete aj ďalších špecialistov na programovanie, matematiku, prácu s obrazom a preklad. Podľa svojej úlohy tak môžete siahnuť po inom modeli.
Model na tvorbu embeddingov na vyhľadávanie vo vlastných dokumentoch: embeddinggemma:300m. Súbor na stiahnutie má 622 MB. Tento model s vami nevedie rozhovor. Text premieňa na vektory, v ktorých potom vyhľadáva príslušná aplikácia. Podrobnosti nájdete v časti 8.
Tri súbory zaberú na disku spolu približne 6,2 GB. To však nie je ich spoločná spotreba pamäte: ak necháte všetky tri modely načítané naraz, voľná pamäť notebooku nemusí stačiť. Načítajte vždy len model, ktorý práve potrebujete. Overte si ho pri skutočnej úlohe a tie, ktoré vám nepomáhajú, odstráňte.
Čo sa mení pri kvantizácii
Rozdiel najlepšie ukazujú verzie toho istého modelu. V katalógu Ollamy má qwen3.5:9b-q4_K_M veľkosť 6,6 GB, qwen3.5:9b-q8_0 11 GB a qwen3.5:9b-bf16 19 GB. Tie isté váhy v troch úrovniach presnosti znamenajú tri rôzne veľkosti súboru na stiahnutie.
Sú to veľkosti súborov v katalógu, nie zaručená spotreba pamäte po načítaní modelu. Nižšia presnosť zmenšuje súbor a často aj pamäťové nároky načítaného modelu. Prípadná strata kvality výstupu závisí od modelu, spôsobu kvantizácie a úlohy. Nepredpokladajte, že kvalita určite klesne, ani že sa nezmení.
Samotné načítané váhy nie sú všetko. Pamäť potrebuje aj kontextové okno so svojou vyrovnávacou pamäťou kľúčov a hodnôt, nehovoriac o ďalších spustených programoch. Pamäť ušetrená kvantizáciou vám teda sama osebe nezaručí, že sa väčší model zmestí. Oproti súboru s plnou presnosťou však máte väčšiu šancu, že ho spustíte.
Dve označenia modelov, pri ktorých ľahko stiahnete nesprávny súbor
Dve označenia v katalógu sa dajú ľahko vyložiť nesprávne. Výsledkom môže byť iný stiahnutý súbor, než ste chceli.
Prvá pasca. Google na karte modelu Gemma 4 E2B uvádza 2,3 miliardy „efektívnych“ jazykových parametrov. Môže to vyvolať dojem, že ide o malý súbor. V Ollame má však 7,2 GB, takmer toľko ako tag gemma4:12b vo verzii Q4 so 7,6 GB. Keď zisťujete, čo sa vám zmestí do notebooku, riaďte sa veľkosťou súboru na stiahnutie, nie počtom parametrov v označení.
Druhá pasca. Samotný názov modelovej rodiny môže bez upozornenia vybrať iný model. Ak stiahnete granite4.2 bez ďalšieho označenia, dostanete model 8B s veľkosťou 5,3 GB, nie tag 3B s veľkosťou 2,2 GB z časti 2. Rovnako pri samotnom qwen3-embedding dostanete model 8B s veľkosťou 4,7 GB, nie verziu 0,6B s veľkosťou 639 MB použitú v časti 8.
V oboch prípadoch platí rovnaké pravidlo: sťahujte model pod presným, úplným tagom, nie iba pod názvom rodiny. Skôr než začnete testovať, skontrolujte aj veľkosť súboru, ktorý sa stiahol.
Aké kontextové okno nastaví Ollama automaticky
Maximum uvedené v katalógu, napríklad 128-tisíc či 256-tisíc tokenov, hovorí, koľko môže model teoreticky prijať. Neznamená to, že také kontextové okno utiahne notebook so 16 GB pamäte.
Ollama predvolene nastavuje kontextové okno na 4 096 tokenov. Môžete ho zväčšiť, no spotreba pamäte rastie s dĺžkou kontextu aj s počtom súbežných požiadaviek. Nastavenie num_ctx: 4096 z druhej časti série zodpovedá práve tejto opatrnej predvolenej hodnote. Nie je to náhodne zvolené okrúhle číslo.
Pri novom modeli začnite s kontextom 4 000 až 8 000 tokenov a vždy len s jednou spustenou reláciou. Pritom sledujte využitie systémovej pamäte. Kontext predlžujte až vtedy, keď uvidíte, že nároky na pamäť zostávajú stabilné, nie iba preto, že katalóg uvádza vyššie maximum.
Ktorý malý AI model vyskúšať na špecializovanú úlohu
Jeden najlepší špecialista na všetko neexistuje. Rozhoduje úloha, ktorú potrebujete vyriešiť; na nasledujúcich modeloch si môžete overiť, ktorý sa na ňu hodí.
Programovanie: qwen2.5-coder:3b (1,9 GB) alebo väčší qwen2.5-coder:7b (4,7 GB). Oba majú licenciu Apache 2.0.
Matematika či logika so zadanými obmedzeniami: phi4-mini:3.8b (2,5 GB) od Microsoftu.
Otázky k obrázkom a snímkam obrazovky: gemma4:e2b (7,2 GB) alebo gemma4:12b vo verzii Q4 (7,6 GB). Oba majú licenciu Apache 2.0 a pri oboch sa uvádza podpora textového aj obrazového vstupu.
Písanie vo viacerých jazykoch alebo preklad: aya-expanse:8b (5,1 GB), vytvorený pre 23 jazykov.
Pri poslednom modeli treba povedať licenčnú výhradu otvorene: Aya Expanse 8B má licenciu CC-BY-NC-4.0 s ďalšími podmienkami a je určený na nekomerčné použitie. Nepovažujte ho preto za možnosť bez takýchto obmedzení popri modeloch s licenciou Apache uvedených vyššie. Ak sa vám nehodí ani jeden z týchto štyroch typov, na všeobecné uvažovanie zostáva granite4.2:3b z časti 2.
Skôr než sa pre niektorý model rozhodnete, vyskúšajte ho na vlastnej úlohe. Špecialistu si nechajte v zostave, ak vám pri nej pomáha, nie preto, že je na čele cudzieho rebríčka.
Najprv test, potom dôvera: päť úloh, ktoré môžete zopakovať
Päť krátkych skúšok vám o modeli povie viac než stránka v katalógu. Každý model, o ktorom uvažujete, preverte rovnakými piatimi úlohami na vlastných podkladoch.
1. Zhrnutie opreté o text. Dajte modelu poznámku s 250 slovami a požiadajte ho, aby z nej vybral tri úlohy na vykonanie. Pri každej má uviesť vetu, z ktorej vychádza. Označte všetko, čo tvrdí bez opory v pôvodnom texte.
2. Údaje v pevnej štruktúre. Vymyslite päť stretnutí s menami a dátumami. Vyžiadajte si JSON presne s poľami, ktoré určíte, a všetkých päť záznamov porovnajte so svojím zadaním.
3. Oprava kódu. Pripravte krátku funkciu, ktorá neprejde testom, a jeden test. Po oprave zaznamenajte, či test prejde. Pri každom porovnávanom modeli použite ten istý repozitár aj kontext.
4. Dvojica jazykov. Požiadajte človeka, ktorý plynule ovláda oba jazyky, aby skontroloval, či si preklad realistického odseku zachoval mená, čísla aj významové odtiene. Viacjazyčné schopnosti neposudzujte len podľa zadania v angličtine.
5. Otázka k obrázku, iba pri modeloch pracujúcich s obrazom. Predložte graf alebo snímku obrazovky s overiteľnou odpoveďou a skontrolujte, či model dostal samotný obrázok, nielen názov súboru.
Pri každom spustení si zaznamenajte, či odpoveď zodpovedá známemu správnemu výsledku, či model dodržal pokyny, čo si prípadne vymyslel, čas do prvého viditeľného výstupu, celkový čas, počty tokenov a to, či bežal na CPU alebo GPU. Užitočnosť a rýchlosť vyhodnocujte zvlášť: model, ktorý pred odpoveďou uvažuje, môže venovať čas aj tokenom, ktoré vôbec nevidíte.
Malé rozšírenie na vyhľadávanie vo vlastných dokumentoch (lokálne RAG)
Model na tvorbu embeddingov z časti 2 má jedinú úlohu: premieňať text na vektory, v ktorých potom vyhľadáva príslušná aplikácia. Sám na otázky neodpovedá.
Na poradí krokov záleží. Súbory sa najprv rozdelia na úseky, model z každého vytvorí vektor a tie sa uložia do lokálneho vektorového úložiska. Na vektor sa zmení aj vaša otázka. Aplikácia potom vyhľadá najbližšie úseky. Až následne na ich základe odpovie konverzačný model a odkáže na použité pasáže.
Konverzačný model sa na vašich dokumentoch nikdy netrénoval. Vidí len úseky, ktoré mu vyhľadávanie poskytne vo chvíli, keď položíte otázku.
Princíp si môžete overiť bez zložitej prípravy: zaraďte do vyhľadávania päť poznámok, ktoré už máte. Pripravte jednu otázku, na ktorú nájdete odpoveď v niektorej z nich, a druhú, na ktorú neodpovedá žiadna. Fungujúca zostava pri prvej nájde správnu pasáž a odkáže na ňu. Pri druhej prizná, že na odpoveď nemá podklady, namiesto toho, aby si ju vymyslela. Kvalitu vyhľadávania a výslednej odpovede vyhodnocujte oddelene.
Pred stiahnutím si overte presný tag modelu na tvorbu embeddingov: embeddinggemma:300m alebo qwen3-embedding:0.6b. Dôvod je rovnaký ako pri skrátených tagoch v časti 4.
Menej aktívnych parametrov neznamená menší súbor
Model s označením napríklad „26B A4B“ využíva pri generovaní každého tokenu iba časť svojich parametrov. Váhy všetkých 26 miliárd parametrov však musí mať stále niekde uložené alebo ich priebežne načítavať. Menej aktívnych parametrov preto neznamená menší súbor ani nižšiu spotrebu pamäte.
V tejto zostave neuvádzame žiadne nové výsledky benchmarkov, ktoré by sme sami namerali. Ak číslo pochádza odinakiaľ, berte do úvahy, na akom hardvéri vzniklo. Príkladom je údaj približne 18,5 tokenu za sekundu od jedného používateľa s nezvyčajnou zostavou: modelom typu MoE s 26 miliardami parametrov, starším CPU a GPU so 6 GB pamäte. Je to výsledok jednej konkrétnej zostavy, nie všeobecné očakávanie pri každom modeli s takýmto označením.
Notebooky, na ktorých sme túto zostavu skúšali
Túto zostavu sme skúšali na dvoch skutočných, aktuálnych notebookoch z druhej časti série: na základnom modeli s čipom Apple Silicon a na pracovnej stanici s Windows a vlastnou grafickou pamäťou. Oba sú repasované (odborne otestované, vyčistené a obnovené) a na refurbed sa na ne vzťahuje 12-mesačná záruka. Táto zostava sa na oboch notebookoch pohodlne zmestí, vždy jeden model naraz.
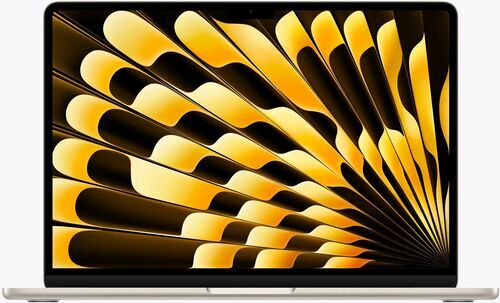
13-palcový MacBook Air (2026) s čipom M5 má štandardne 16 GB zjednotenej pamäte; nakonfigurovať sa dá až na 32 GB. Dell Precision 7730 má 32 GB systémovej pamäte a vlastných 6 GB vyhradenej grafickej pamäte NVIDIA (VRAM). Ide o dve oddelené pamäte, nie o jedno spoločné číslo.
Nespomíname ich preto, aby sme vám ich predali. Práve na nich sme návod skúšali, takže svoj notebook môžete porovnať s niečím konkrétnym, nielen s údajmi z reklamného technického listu.

Licencie a výber modelov bez zbytočných omylov
Licencia sa vzťahuje na konkrétny model, nie na celú rodinu. Qwen3.5 4B, Qwen2.5-Coder, Granite 4.2 3B a Gemma 4 E2B majú licenciu Apache 2.0. Aya Expanse 8B má, ako už zaznelo v časti 6, licenciu CC-BY-NC-4.0 s ďalšími podmienkami a je určený na nekomerčné použitie. Možnosť stiahnuť si váhy modelu, autorskoprávne oprávnenie používať ich a predstava, že vám „patrí“ samotný model, sú tri odlišné veci. Preto si pozrite aktuálnu kartu presne toho modelu, ktorý sťahujete, nie iba názov jeho rodiny.
Malú zostavu si udržíte len vtedy, keď z nej budete priebežne vyraďovať modely, ktoré nevyužívate. Príkaz ollama rm odstráni stiahnutý model, ktorý sa vám neosvedčil. Ak napríklad viete, že aya-expanse:8b nevyužijete, odstránite ho príkazom ollama rm aya-expanse:8b. Príkaz ollama ls zobrazí modely uložené na disku a ollama ps tie, ktoré sú práve načítané. Katalógy sa menia, preto svoj výber po čase prehodnoťte, namiesto toho, aby ste sa spoliehali na rozhodnutie spred mesiacov.
Aj malé modely si môžu vymyslieť pasáž, prehliadnuť významový odtieň v inom jazyku alebo napísať kód, ktorý vyzerá správne, ale testom neprejde. Každé odporúčanie v tomto článku berte ako podnet na vlastný pokus, nie ako náhradu odbornej kontroly tam, kde na výsledku záleží.
Časté otázky o malých AI modeloch na lokálne spustenie
Môžem spustiť všetky tri modely zo zostavy súčasne? Na notebooku so 16 GB pamäte zrejme nie pohodlne. Nechajte načítaný len model na aktuálnu úlohu a potom ho vymeňte. Asistenta, špecialistu aj model na tvorbu embeddingov tak nemusíte držať v pamäti naraz.
Potrebuje model na tvorbu embeddingov GPU? Nie. embeddinggemma:300m je dosť malý na skúšku iba s CPU. Aj tak si však zmerajte, koľko trvá, kým dostanete výsledok; nepredpokladajte, že to bude okamžite.
Dá väčší model vždy lepšiu odpoveď? Nie. To, či si pri konkrétnej úlohe povedie lepšie model 4B alebo 9B, závisí od samotnej úlohy. Preto v časti 7 nájdete päť testov namiesto jediného čísla z rebríčka.
Stačí verzia Q4? Závisí od úlohy. Ak máte dosť pamäte na spustenie oboch verzií, porovnajte tag Q4 s tagom Q8 toho istého modelu v troch vlastných testoch, podobne ako pri porovnaní v časti 3.
Môžem použiť Aya Expanse v komerčnom projekte? Nie automaticky. Licencia CC-BY-NC-4.0 pokrýva nekomerčné použitie a platia aj ďalšie podmienky. Skôr než budete počítať s komerčným použitím, pozrite si aktuálnu kartu modelu.
Potrebuje model na tvorbu embeddingov po stiahnutí internet? Nie. Rovnako ako ostatné modely z tejto zostavy funguje po stiahnutí váh offline.
Teraz ste na rade vy: nainštalujte modely, otestujte ich a nechajte si užitočný
Nainštalujte 4B asistenta a jedného špecialistu, ktorý sa hodí na vašu úlohu. Použite notebook, pri ktorom vám prvá časť pomohla posúdiť nároky na pamäť a druhá pripraviť lokálne prostredie. Vyskúšajte vlastnú trojotázkovú verziu testu z časti 7. Model, ktorý vám pomôže, si ponechajte; druhý odstráňte príkazom ollama rm. O dokúpení pamäte uvažujte až vtedy, keď pri skutočnej úlohe zistíte, že vás obmedzuje práve ona, nie na základe tabuľky parametrov.
Tým sa naša trojdielna séria končí. Ak ste zistili, že váš notebook potrebuje na tieto úlohy viac pamäte, rozumným východiskom je kategória notebookov.

Prihláste sa na odber nášho newslettra po prvý raz a ušetrite 15 €!
Už nikdy nezmeškajte ponuku.
Informácie o používaní osobných údajov nájdete v našich Zásadách ochrany osobných údajov.
Získajte aplikáciu refurbed
Pre iOS a Android


Potvrdiť prihlásenie
Už to skoro máme: Poslali sme vám potvrdzovací e-mail
- © Refurbed Marketplace GmbH
- Prístupnosť
- Všeobecné obchodné podmienky
- Ochrana osobných údajov
- Impressum
- Právne upozornenia
- European Data Act
- Cookie Policy